


Według raportu Flexera 2025 State of the Cloud 84% organizacji uważa zarządzanie wydatkami na chmurę za swoje największe wyzwanie, a budżety na chmurę są przekraczane średnio o 17%. Oszczędności zwykle szuka się w cennikach, rezerwacjach i rozmiarach instancji. Rzadziej w samej aplikacji, choć w środowisku z autoskalowaniem to ona decyduje, ile serwerów pracuje.
Przekonaliśmy się o tym na platformie TCAdvert, systemie digital signage, który rozwijamy i utrzymujemy w AWS dla IMS Sensory Media. Z jej API łączy się w ciągu doby około 15 tysięcy playerów. We wrześniu 2025 roku przenieśliśmy to API z Apache i PHP-FPM na FrankenPHP z Laravel Octane, a bazę danych wykorzystywaną do przechowywania zdarzeń z urządzeń z Grafana Loki na VictoriaLogs.
Opisujemy, dlaczego klasyczny stack przestał wystarczać, jak działa FrankenPHP, czego wymaga od zespołu tryb worker i co zmieniło się po roku na produkcji. Największą różnicę zrobiły nie mocniejsze serwery, tylko zmiana tego, jak aplikacja obsługuje żądania.
Dlaczego platforma digital signage IMS Sensory Media potrzebowała migracji z PHP-FPM?
Kiedy w systemie pracuje kilkadziesiąt urządzeń, prawie każda architektura po prostu działa. Przy kilkunastu tysiącach drobne nieefektywności zaczynają kosztować prawdziwe pieniądze i czas inżynierów. Zanim przejdziemy do szczegółów, krótkie podsumowanie efektów migracji.
| Obszar | Efekt migracji |
| Taski AWS Fargate obsługujące ruch API | o 57% mniej przy tym samym ruchu |
| Czas odpowiedzi API dla urządzeń (p95) | z ok. 350 ms do ok. 90 ms |
| Wyszukiwanie w logach z urządzeń | z kilkunastu sekund do ok. 0,5 s |
| Migracja systemu logów | bez utraty danych i bez wpływu na działanie platformy |
Skala systemu TCAdvert, czyli około 15 tysięcy playerów i dziesiątki milionów logów dziennie
IMS Sensory Media to notowana na GPW spółka z obszaru marketingu sensorycznego i digital signage. TCAdvert zarządza treściami na ekranach w ponad 10 tysiącach obiektów, od galerii handlowych po sieci retail i salony marek. Każdy ekran ma swojego playera, czyli urządzenie, które synchronizuje treści, raportuje stan i wysyła do centralnego API logi, czyli zdarzenia występujące na danym urządzeniu.
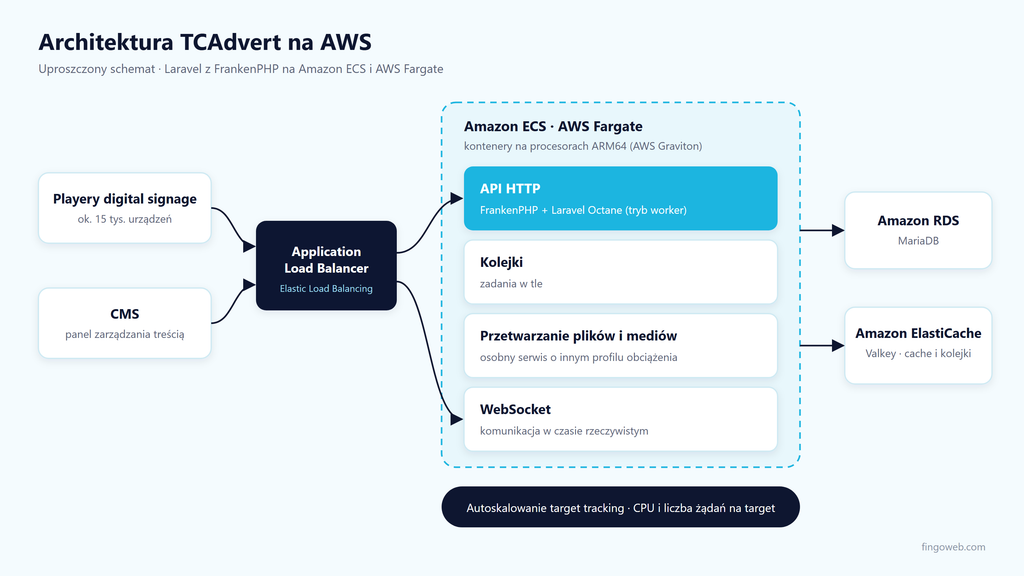
Na tym polega specyfika takich systemów. Ruch nie pochodzi od ludzi klikających w aplikację, tylko od tysięcy urządzeń, które regularnie wysyłają zapytania do API i raportują zdarzenia. Przy tej skali,daje to dziesiątki milionów wpisów w logach dziennie. TCAdvert API to oparta o framework Laravel uruchamiana na Amazon ECS z AWS Fargate, na procesorach ARM64 (AWS Graviton), za Application Load Balancerem. Ruch i zadania są rozdzielone na osobne serwisy:
- ruch HTTP – API, z którym komunikują się playery i CMS,
- kolejki z zadaniami w tle,
- kolejki obsługujące przetwarzanie plików i mediów – osobno, bo ma zupełnie inny profil obciążenia niż pozostałe zadania które są zlecane do wykonania w kolejkach,
- WebSocket.
Dane trzymamy w Amazon RDS (MariaDB), a cache i kolejki w Amazon ElastiCache (Valkey).
Liczba tasków nie jest stała. ECS skaluje je w modelu target tracking, czyli dokłada i wyłącza taski tak, żeby utrzymać zadane wartości. U nas są to trzy sygnały, średnie zużycie CPU, zużycie pamięci i liczba żądań na jeden target za load balancerem. Ten szczegół zmienia sposób myślenia o wydajności. Wszystko, co pozwala jednemu taskowi obsłużyć więcej ruchu, automatycznie zmniejsza liczbę tasków, za które płacisz.
Jak działa FrankenPHP i czym różni się od PHP-FPM?
Żeby zrozumieć, skąd wzięła się oszczędność, trzeba spojrzeć na to, jak PHP obsługuje pojedyncze żądanie. Różnica między PHP-FPM a FrankenPHP w trybie worker nie polega na szybszym serwerze, tylko na innym modelu wykonania.
Dlaczego PHP-FPM marnuje CPU przy dużym ruchu?
Przez lata standardem był serwer WWW, czyli Apache albo Nginx, z pulą procesów PHP-FPM obok. Serwer przyjmuje żądanie, przekazuje je do procesu PHP-FPM, a ten wykonuje skrypt i zwraca odpowiedź. Model jest prosty i niezawodny, tyle że każde żądanie przechodzi przez pełny cykl życia aplikacji od zera:
- Interpreter PHP się inicjalizuje.
- Ładuje się autoloader i zależności.
- Startuje framework i czyta konfigurację.
- Aplikacja nawiązuje połączenia.
Dopiero potem wykonuje się właściwa logika, która w API często sprowadza się do jednego zapytania do bazy i zwrócenia JSON-a. W aplikacji wielkości Laravela narzut tego rozruchu bywa porównywalny z czasem samej logiki biznesowej, a czasem go przewyższa. Opcache pomaga, bo trzyma skompilowany kod w pamięci, ale nie zwalnia z wykonania kodu inicjalizującego.
W ECS miało to konkretną cenę. Duża część CPU szła na powtarzany bootstrap, więc autoskalowanie szybciej przekraczało próg i dokładało kolejne taski Fargate. Płaciliśmy za wielokrotne wykonywanie tej samej pracy, a nie za obsługę realnego ruchu.
Tryb worker we FrankenPHP, czyli aplikacja, która zostaje w pamięci
FrankenPHP to nowoczesny serwer aplikacyjny PHP zbudowany na bazie serwera Caddy, który łączy serwer WWW i runtime PHP w jednym procesie. Jego najważniejsza funkcja to tryb worker. Aplikacja uruchamia się raz, przy starcie procesu roboczego, a kolejne żądania trafiają już do w pełni zainicjalizowanego frameworka. Połączenia z bazą danych są utrzymywane między żądaniami.
Różnicę dobrze oddaje porównanie z kuchnią w restauracji. PHP-FPM przy każdym zamówieniu rozpala piec od nowa, a tryb worker trzyma go rozgrzanego przez cały wieczór. Dla nas liczyła się też prostota stosu. Jeden proces zastępuje parę serwer WWW i pula PHP-FPM, a Caddy daje czytelniejsze pliki konfiguracyjne i wbudowaną kompresję zstd.
FrankenPHP i PHP-FPM w porównaniu
Poniżej znajdziesz tabele gdzie porównujemy PHP-FPM z Apache lub Nginx z FrankenPHP w trybie worker.
| Cecha | PHP-FPM (z Apache lub Nginx) | FrankenPHP w trybie worker |
| Model wykonania | proces obsługuje żądanie i wraca do puli | aplikacja startuje raz i obsługuje żądania w pętli |
| Rozruch frameworka | przy każdym żądaniu | raz, przy starcie workera |
| Połączenia z bazą danych | nawiązywane na nowo | utrzymywane między żądaniami |
| Stan między żądaniami | zawsze czysty | utrzymuje się i wymaga kontroli |
| Elementy stosu | serwer WWW i osobna pula PHP-FPM | jeden proces (Caddy i runtime PHP) |
Ostatnie dwa wiersze to cena, którą płaci się za wydajność. Wracamy do nich w części o migracji.
Migracja na FrankenPHP z Laravel Octane na AWS Fargate
Do połączenia Laravela z trybem worker użyliśmy Laravel Octane, który zarządza stanem aplikacji między żądaniami. Zmianę wdrożyliśmy na produkcji we wrześniu 2025 roku. Sama podmiana serwera okazała się najprostszą częścią, więcej uwagi wymagał kod.
Jak przygotować aplikację Laravel do trybu worker?
W PHP-FPM każdy proces kończy pracę po żądaniu, więc stan globalny, zmienne statyczne i singletony zawsze zaczynają od zera. W trybie worker proces żyje długo. Zmienna statyczna ustawiona przy jednym żądaniu będzie widoczna przy następnym, a singleton zarejestrowany w kontenerze nie zniknie. Daje to wydajność, ale bywa też źródłem błędów, jeśli kod zakłada świeży start.
Octane zdejmuje większość tego ciężaru, bo odświeża kontener i wybrane usługi przed każdym żądaniem. Odpowiedzialność nie znika jednak całkowicie. Przed migracją warto przejrzeć własne usługi pod jednym kątem, czyli czy nie przechowują danych konkretnego żądania w miejscach, które przeżywają request.
Pamięć i restart workerów w długo żyjących procesach
Drugi temat to pamięć. Proces, który obsługuje kolejne żądania, stopniowo zbiera drobne wycieki, których w PHP-FPM nikt nie zauważał, bo proces i tak kończył pracę po chwili. W trybie worker taki proces w końcu urośnie. Dlatego workery okresowo restartujemy po określonej liczbie obsłużonych żądań.
FrankenPHP na produkcji po roku. Wyniki dla IMS Sensory Media
Tryb worker obniża zużycie CPU na jedno żądanie, więc autoskalowanie rzadziej przekracza progi. Po migracji liczba tasków Fargate obsługujących ruch API spadła o 57%, a koszt Fargate dla tej części infrastruktury zmalał proporcjonalnie. Zaoszczędzone środki przeznaczyliśmy na usprawnienia w AWS, które przyspieszyły CMS.
Drugi efekt widać w czasach odpowiedzi. Dla API, z którym komunikują się urządzenia, p95 spadł z około 350 ms do około 90 ms. Ważniejsze od samego spadku jest to, że czas odpowiedzi stał się przewidywalny. Pełny opis projektu znajdziesz w case study dotyczący optymalizacji infrastruktury AWS dla projektu TCAdvert w naszym portfolio.
VictoriaLogs zamiast Grafana Loki w logach z urządzeń digital signage
Druga zmiana dotyczyła zupełnie innej części systemu, czyli logów z urządzeń. Tu nie chodziło o koszt, tylko o czas, który zespół wsparcia tracił na szukanie przyczyn problemów.
Dlaczego Grafana Loki nie radził sobie z wyszukiwaniem po player_id?
Każdy player wysyła logi z synchronizacji treści, błędów odtwarzania, zmian statusu i incydentów. Kiedy ekran w galerii po drugiej stronie kraju przestaje wyświetlać treści, zespół wsparcia musi szybko odfiltrować historię tego jednego urządzenia i znaleźć komunikat, który tłumaczy problem.
Grafana Loki indeksuje same etykiety, a nie treść logów. Każda unikalna kombinacja etykiet to osobny strumień, więc zgodnie z dobrą praktyką w etykietach trzyma się wymiary o niskiej kardynalności. Identyfikator urządzenia do nich nie należy, bo osobny strumień dla każdego z tysięcy playerów obciążyłby cały system. Grupowaliśmy więc urządzenia w większe przedziały, ale wyciągnięcie logów jednego playera i tak kończyło się przeszukiwaniem treści, w którym Loki jest wolny.
Zaawansowane zapytania trwały kilkanaście sekund, a w gorszych przypadkach jeszcze dłużej. Konfiguracja obrastała obejściami, które łagodziły objawy, ale nie usuwały przyczyny.
Co zmieniło przejście na VictoriaLogs?
VictoriaLogs to silnik logów od twórców VictoriaMetrics, zaprojektowany pod wysoką wydajność przy niskim zużyciu zasobów. W naszym przypadku liczyły się cztery rzeczy:
- pełnotekstowe wyszukiwanie bez deklarowania z góry, po czym będziemy szukać,
- filtry Blooma i partycjonowanie w czasie – silnik pomija bloki danych, które na pewno nie zawierają szukanej frazy, a usuwanie starych danych sprowadza się do skasowania partycji,
- identyfikator playera jako zwykłe pole, po którym filtrujemy wprost,
- język zapytań LogsQL, który odpytujemy z API i pokazujemy bezpośrednio w CMS, tam gdzie logi są potrzebne zespołowi wsparcia.
Dziś zapytanie o logi zwraca wyniki w około 0,5 sekundy, bez dokładania zasobów. Zespół wsparcia znów diagnozuje urządzenia na bieżąco.
Migracja logów bez utraty danych, czyli strategia dual-sink
Logów produkcyjnych nie da się odtworzyć. Jeśli coś zgubi się przy przełączaniu, nie ma jak cofnąć czasu. Zamiast twardego przełączenia wykorzystaliśmy pipeline, który już mieliśmy. Aplikacja wysyła logi w standardzie OpenTelemetry do Vectora, a ten kieruje je do magazynu, więc wymiana magazynu to zmiana konfiguracji, a nie aplikacji. Migracja przebiegła w pięciu krokach:
- Przenieśliśmy wysyłkę logów z bezpośredniego API Lokiego na OpenTelemetry i ustawiliśmy transport tak, żeby urządzenie ponawiało wysyłkę, jeśli Vector nie potwierdzi odbioru.
- Włączyliśmy buforowanie dyskowe w Vectorze, które paczkuje zapisy do nowego magazynu.
- Za pomocą Vector Remap Language przekształcaliśmy logi jednocześnie do formatu Lokiego i VictoriaLogs.
- Przez okres przejściowy, co najmniej tak długi jak retencja w Lokim, te same logi trafiały równolegle do obu systemów.
- Po porównaniu obu systemów 1:1 na żywym ruchu wyłączyliśmy Lokiego.
Nowy system sprawdzaliśmy więc na prawdziwych danych, a nie na sztucznym benchmarku. Gdyby VictoriaLogs nie spełniło oczekiwań, moglibyśmy przerwać wdrożenie bez ryzyka dla platformy. Efektem ubocznym okazał się krótszy czas odpowiedzi na żądania, w których urządzenia wysyłają logi.
Kiedy migracja na FrankenPHP ma sens?
Apache z PHP-FPM i Grafana Loki to dojrzałe narzędzia, które w ogromnej liczbie projektów w pełni wystarczają. Nie wymieniliśmy ich dlatego, że są złe. Wymieniliśmy je, bo profil obciążenia TCAdvert wyszedł poza granice, w których ich architektura sprawdza się najlepiej.
Sygnały, że PHP-FPM przestaje wystarczać
Na podstawie naszego przypadku zwrócilibyśmy uwagę na trzy sygnały:
- dużo równoległych, krótkich żądań do API – zwłaszcza gdy większość z nich to proste zapytanie do bazy, a rozruch frameworka trwa porównywalnie długo,
- autoskalowanie po CPU, które dokłada serwery szybciej, niż rośnie ruch,
- zespół gotowy pilnować stanu w długo żyjących procesach – bez tego zysk z trybu worker łatwo zamienia się w błędy, które trudno znaleźć.
Projekty, w których PHP-FPM w zupełności wystarcza
Jeśli aplikacja ma umiarkowany ruch, nie skaluje się automatycznie albo koszt serwerów nie jest dla Ciebie problemem, migracja może się nie opłacić. Przy małej skali prawie każda architektura po prostu działa, a przegląd kodu pod tryb worker też kosztuje czas zespołu. Decyzję warto zacząć od pomiaru, ile czasu aplikacja traci na rozruch przy każdym żądaniu.

Najczęściej zadawane pytania
Jak działa FrankenPHP?
FrankenPHP osadza interpreter PHP bezpośrednio w serwerze Caddy napisanym w Go, więc serwer WWW i PHP działają jako jeden proces. W trybie worker aplikacja startuje raz i obsługuje kolejne żądania z pamięci, bez ponownego ładowania frameworka. Bez trybu worker FrankenPHP działa w klasycznym modelu, podobnym do PHP-FPM.
Jak użyć FrankenPHP z Laravelem?
Najprostsza droga prowadzi przez Laravel Octane, który obsługuje FrankenPHP jako jeden z serwerów. W praktyce wygląda to tak:
- instalujesz Laravel Octane i wybierasz FrankenPHP jako serwer,
- sprawdzasz, czy Twoje usługi nie trzymają danych konkretnego żądania w zmiennych statycznych lub singletonach,
- ustawiasz restart workerów po określonej liczbie żądań.
Reset kontenera między żądaniami Octane robi za Ciebie.
Czy FrankenPHP jest szybszy od PHP-FPM?
Sam serwer niczego nie przyspiesza w cudowny sposób. Zysk daje tryb worker, który pomija rozruch frameworka przy każdym żądaniu. U nas p95 API dla urządzeń spadł z około 350 ms do około 90 ms, ale wynik zależy od tego, jak duży jest bootstrap Twojej aplikacji w porównaniu z samą logiką.
Czy warto używać FrankenPHP na produkcji?
Naszym zdaniem tak, jeśli zespół rozumie konsekwencje trybu worker. U nas FrankenPHP obsługuje produkcyjne API od września 2025 roku. Od maja 2025 roku projekt jest też oficjalnie wspierany przez PHP Foundation, a jego kod trafił do oficjalnej organizacji PHP na GitHubie, co dobrze wróży jego dalszemu rozwojowi.
Czym VictoriaLogs różni się od Grafana Loki?
Oba systemy przechowują logi, ale inaczej je indeksują:
- Grafana Loki indeksuje tylko etykiety, więc wyszukiwanie po polach o wysokiej kardynalności, takich jak identyfikator urządzenia, kończy się skanem treści,
- VictoriaLogs pozwala filtrować po dowolnym polu i przeszukiwać pełną treść, a bloki bez szukanej frazy pomija dzięki filtrom Blooma.
Przy około 15 tysiącach urządzeń ta różnica zdecydowała u nas o wyborze.